Claude schlägt GPT – aber überzeugt noch nicht
Eine Studie von Wortliga im Auftrag von Sistrix verglich 2112 B2B-Marketingtexte von Claude, Gemini und GPT. Das Ergebnis ist eindeutig: Kein Modell schreibt ohne präzises Prompting verständlich genug – und das birgt Risiken für Unternehmen.


KI-Sprachmodelle gelten als effiziente Helfer für Marketing und Vertrieb. Doch wie gut sind sie tatsächlich? Eine Studie von Wortliga im Auftrag des SEO-Analyseanbieters Sistrix liefert erstmals einen systematischen Vergleich der Flaggschiff-Modelle von Anthropic, Google und OpenAI – und kommt zu einem ernüchternden Befund.
2112 Texte, elf Gattungen, drei Modelle
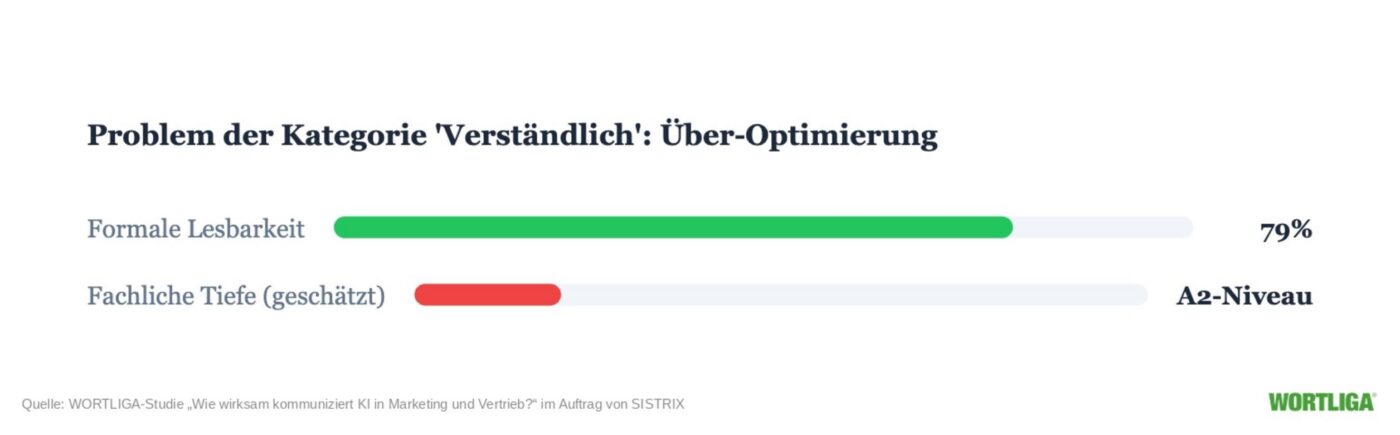
Die Analyse umfasste 2112 B2B-Texte aus elf Textgattungen, darunter Social-Media-Beiträge, Werbe-E-Mails, SEO-Blogartikel, Case Studies und Whitepaper. Die Qualität der Texte wurde anhand des WORTLIGA-Scores gemessen, der Lesbarkeit, sprachliche Hürden wie Schachtelsätze und Passiv-Jargon sowie Klang und Substanz bewertet. Als verständlich gelten Texte erst ab einem Wert von 60 Punkten.
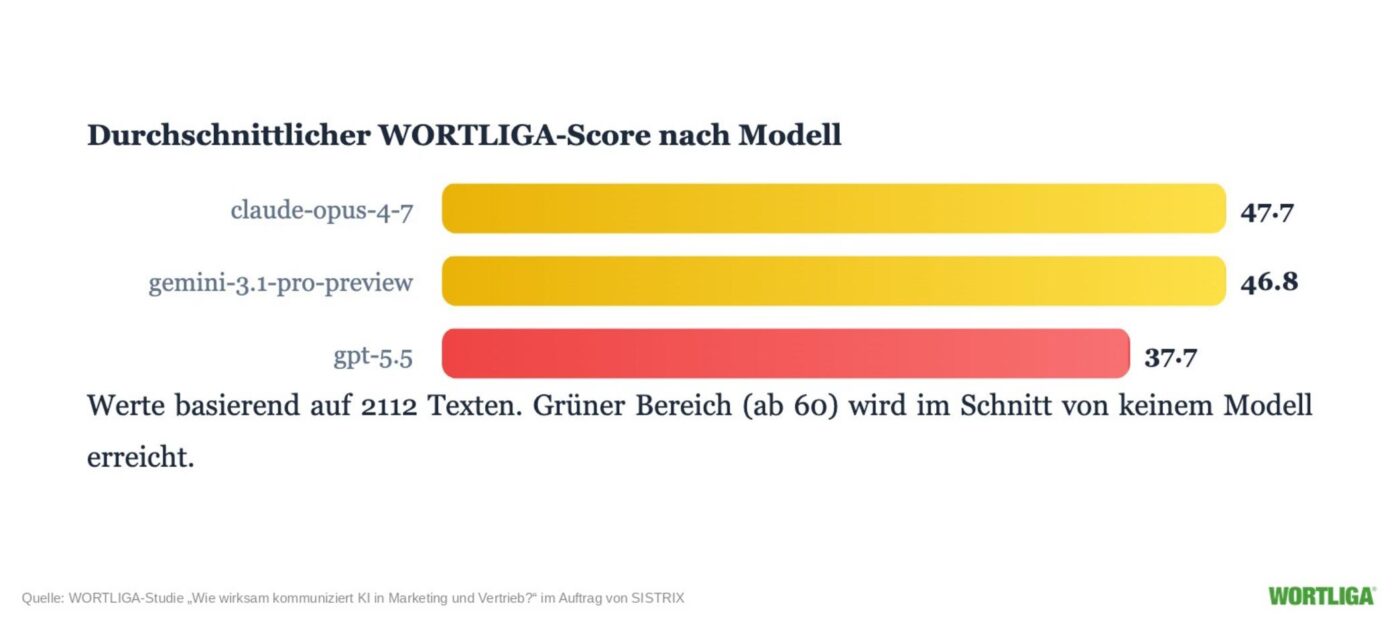
Das Resultat: Claude Opus 4.7 von Anthropic belegte den ersten Platz und lieferte branchenübergreifend die stabilsten sprachlichen Ergebnisse – mit einem durchschnittlichen Score von 47,7 Punkten. Gemini 3.1 Pro (Vorabversion) von Google folgte auf dem zweiten Platz mit 46,8 Punkten, fiel aber durch eine auffällige Häufung von Floskeln und Füllwörtern auf. Das Modell GPT 5.5 von OpenAI belegte mit lediglich 37,7 Punkten den letzten Platz. Ohne genaue Regeln tendiert es zu Beamtendeutsch und komplexer Fachsprache.
Unkontrollierter KI-Einsatz ist riskant
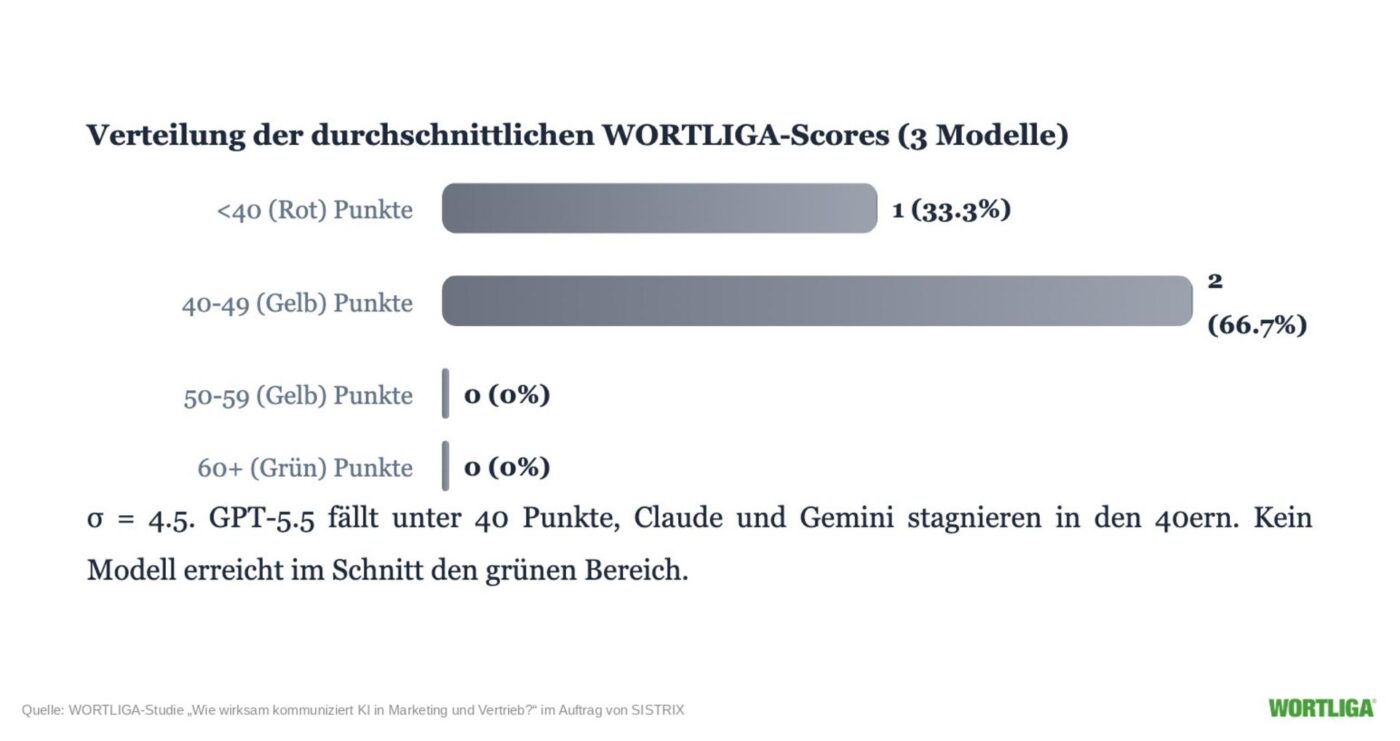
Studienleiter Gidon Wagner von Wortliga zieht eine klare Schlussfolgerung: «Die Ergebnisse zeigen, dass die unkontrollierte KI-Kommunikation in Marketing und Vertrieb riskant ist.» Kein einziges der drei Modelle erreichte den Schwellenwert von 60 Punkten für verständliche Texte – selbst das beste Modell blieb weit darunter.
Für Johannes Beus, Gründer und CEO von Sistrix, geht es dabei um mehr als Stilfragen: «Ob ein Text von einem KI-System korrekt interpretiert wird, hängt unter anderem von seiner sprachlichen Klarheit und Struktur ab. Sprache ist keine Geschmacksfrage mehr. Was also lange als ‹nice to have› galt, ist heute sowohl aus Accessibility-Sicht als auch aus der Perspektive maschinenlesbarer Inhalte ein starkes Qualitätskriterium.»
Der Chamäleon-Effekt beim Prompting
Ein weiterer zentraler Befund der Studie ist der sogenannte Chamäleon-Effekt: Enthält ein Prompt einen distanziert-formellen Stil, übernehmen die Modelle diesen unweigerlich – und die Verständlichkeit bricht drastisch ein. Im Schnitt erreichten die Texte unter solchen Bedingungen nur noch 4,4 Punkte. Werbe-E-Mails lasen sich dann wie behördliche Schreiben. Besonders ausgeprägt war dieses Verhalten bei GPT 5.5.
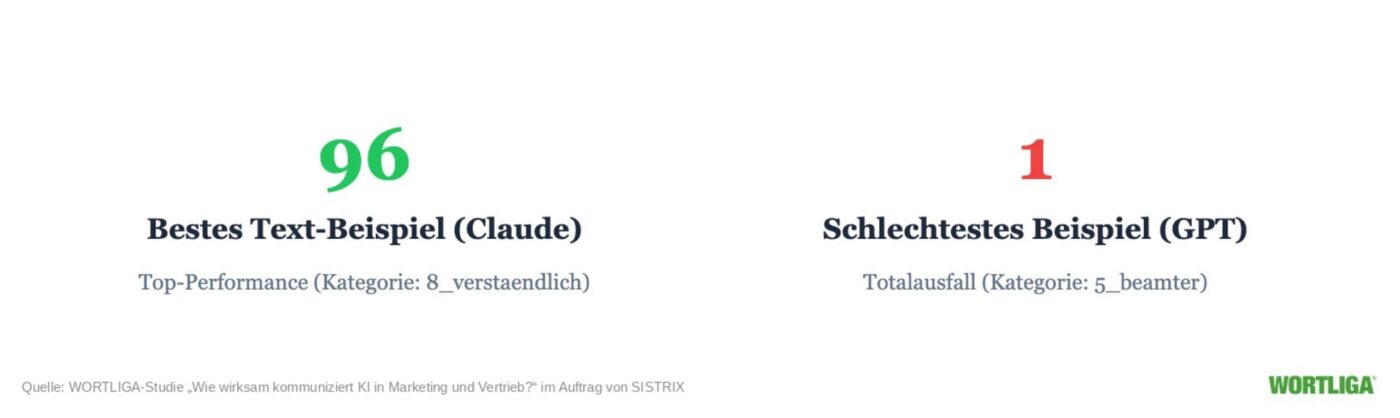
Die Systeme ignorierten bei nachlässigen Prompts sogar die Regeln für bestimmte Textarten. Das zeigt: Nicht das Modell allein entscheidet über die Qualität – sondern die Qualität der Anweisung, die ihm gegeben wird.
Mensch bleibt unverzichtbar
Die Studie hält fest, dass KI-Modelle von sich aus keine überzeugenden B2B-Texte schreiben. Gidon Wagner bringt es auf den Punkt: «Die Daten zeigen, dass KI-Modelle von Haus aus keine überzeugenden B2B-Texte schreiben.» Johannes Beus ergänzt im Vorwort der Studie: «Es ist eine ehrliche Bestandsaufnahme dessen, was künstliche Intelligenz heute tatsächlich leistet und wo der Mensch nach wie vor unverzichtbar bleibt.»
Weitere Informationen: https://wortliga.de/