Claude bat GPT, mais ne convainc pas encore
Une étude réalisée par Wortliga pour le compte de Sistrix a comparé 2 112 textes de marketing B2B générés par Claude, Gemini et GPT. Le résultat est sans appel : sans consignes précises, aucun modèle ne rédige de manière suffisamment compréhensible, ce qui comporte des risques pour les entreprises.


Les modèles linguistiques basés sur l'IA sont considérés comme des outils efficaces pour le marketing et la vente. Mais quelle est leur efficacité réelle ? Une étude réalisée par Wortliga pour le compte du prestataire d’analyses SEO Sistrix propose pour la première fois une comparaison systématique des modèles phares d’Anthropic, de Google et d’OpenAI – et aboutit à un constat décevant.
2 112 textes, onze genres, trois modèles
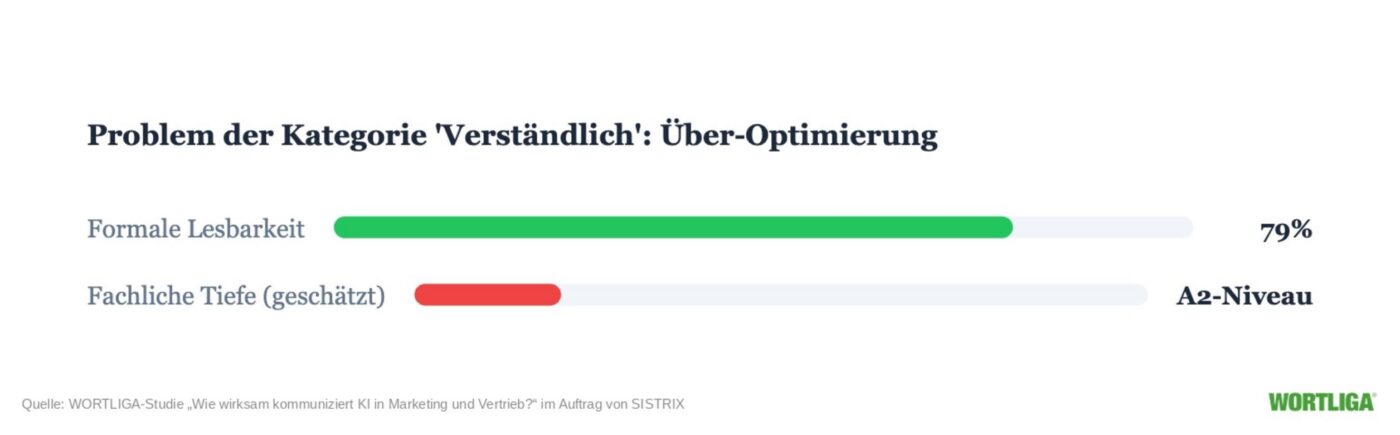
L'analyse a porté sur 2 112 textes B2B issus de onze genres différents, parmi lesquels des publications sur les réseaux sociaux, des e-mails publicitaires, des articles de blog optimisés pour le référencement, des études de cas et des livres blancs. La qualité des textes a été mesurée à l'aide du score WORTLIGA, qui évalue la lisibilité, les obstacles linguistiques tels que les phrases alambiquées et le jargon passif, ainsi que la fluidité et le fond. Seuls les textes obtenant une note supérieure ou égale à 60 points sont considérés comme compréhensibles.
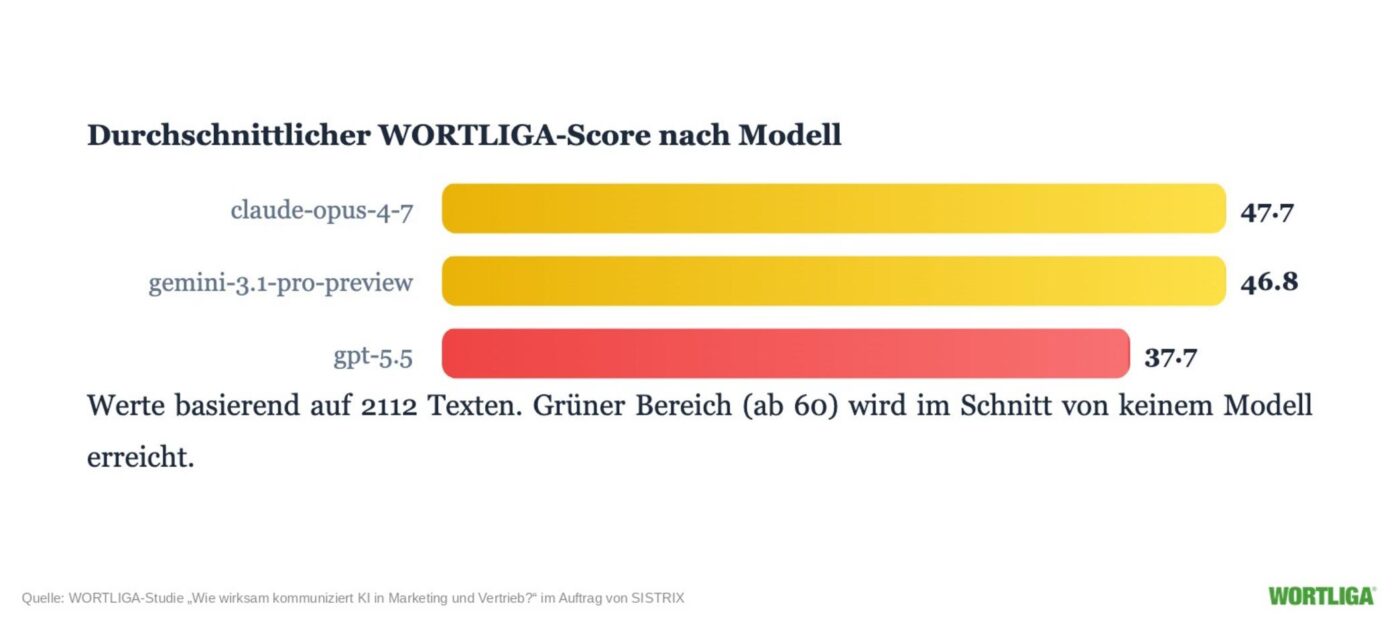
Résultat : Claude Opus 4.7 d'Anthropic s'est classé en tête et a fourni les résultats linguistiques les plus stables tous secteurs confondus, avec un score moyen de 47,7 points. Gemini 3.1 Pro (version préliminaire) de Google a suivi en deuxième position avec 46,8 points, mais s’est distingué par une accumulation flagrante de formules toutes faites et de mots de remplissage. Le modèle GPT 5.5 d’OpenAI a occupé la dernière place avec seulement 37,7 points. En l’absence de règles précises, il a tendance à produire un allemand bureaucratique et un langage technique complexe.
Une utilisation incontrôlée de l'IA comporte des risques
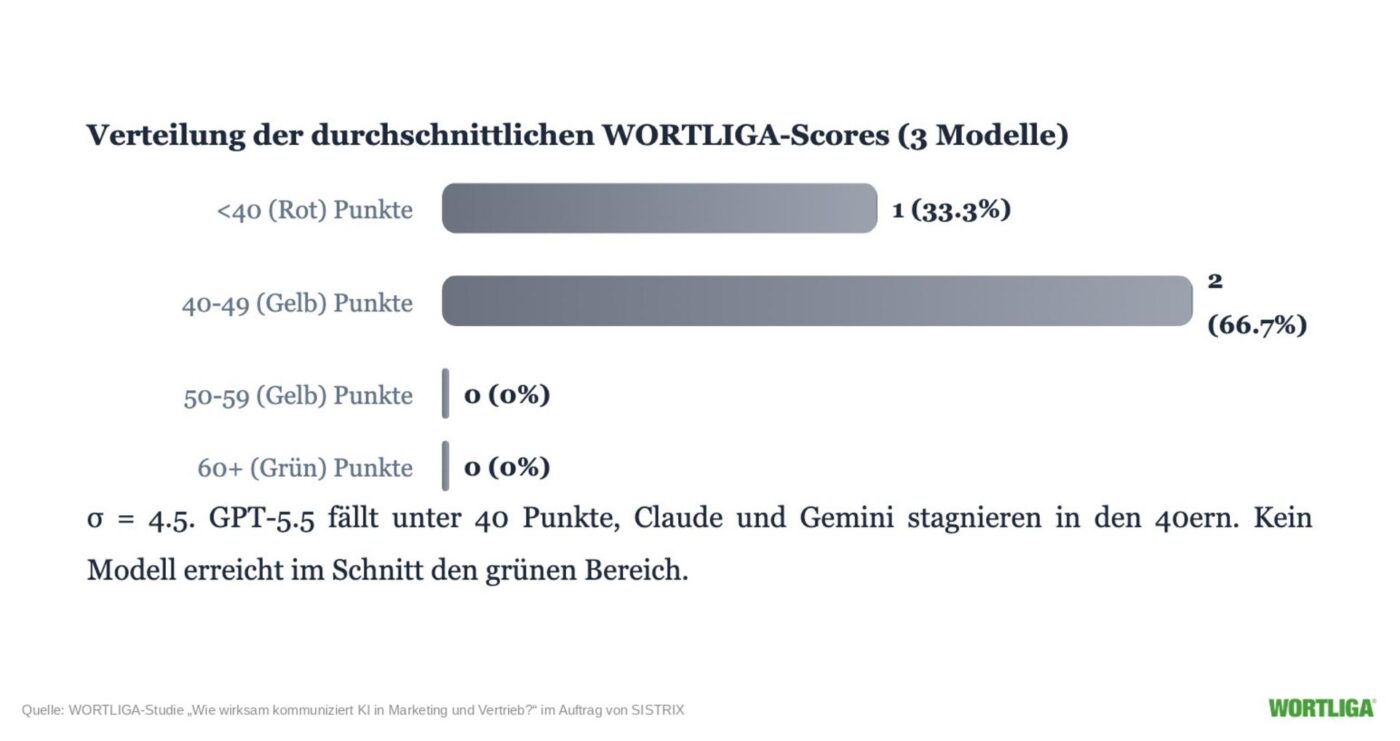
Gidon Wagner, responsable de l'étude chez Wortliga, tire une conclusion claire : « Les résultats montrent que l'utilisation non contrôlée de l'IA dans la communication marketing et commerciale comporte des risques. » Aucun des trois modèles n'a atteint le seuil de 60 points requis pour des textes compréhensibles ; même le meilleur modèle est resté bien en deçà.
Pour Johannes Beus, fondateur et PDG de Sistrix, cela va bien au-delà des simples questions de style : « La capacité d’un système d’IA à interpréter correctement un texte dépend, entre autres, de la clarté et de la structure de celui-ci. La langue n’est plus une question de goût. Ce qui était longtemps considéré comme un » plus » est aujourd’hui un critère de qualité essentiel, tant du point de vue de l’accessibilité que de celui des contenus lisibles par les machines. »
L'effet « caméléon » dans le prompting
Une autre conclusion majeure de l'étude est ce qu'on appelle « l'effet caméléon » : lorsqu'une consigne adopte un style distant et formel, les modèles le reproduisent inévitablement, ce qui entraîne une chute drastique de la compréhensibilité. En moyenne, les textes n’atteignaient plus que 4,4 points dans ces conditions. Les e-mails publicitaires se lisaient alors comme des courriers administratifs. Ce comportement était particulièrement marqué chez GPT 5.5.
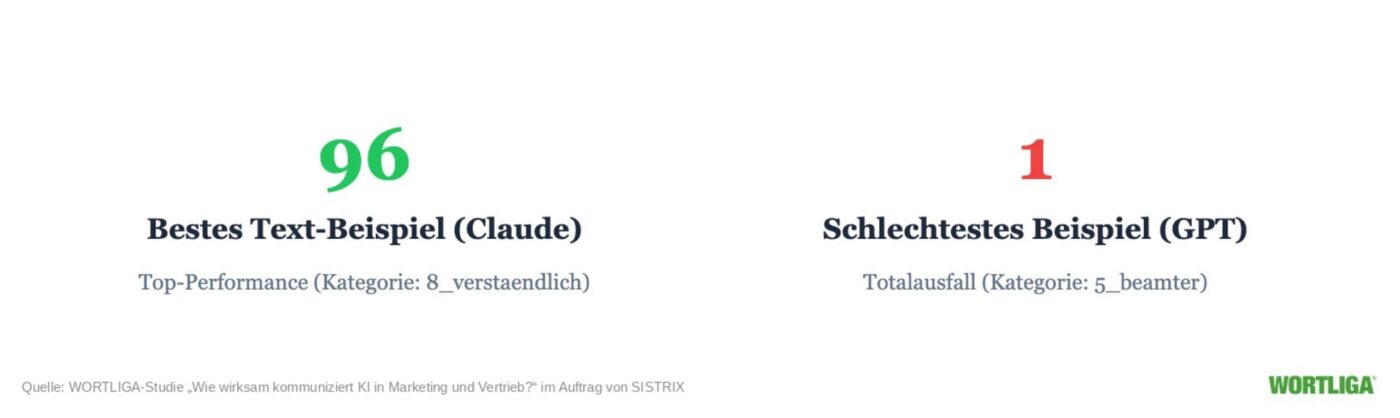
Face à des consignes imprécises, les systèmes allaient même jusqu’à ignorer les règles applicables à certains types de textes. Cela montre que ce n’est pas le modèle seul qui détermine la qualité, mais bien la qualité de la consigne qui lui est donnée.
L'être humain reste indispensable
L'étude souligne que les modèles d'IA ne sont pas capables, à eux seuls, de rédiger des textes B2B convaincants. Gidon Wagner résume la situation en ces termes : « Les données montrent que les modèles d'IA ne sont pas, par nature, capables de rédiger des textes B2B convaincants. » Johannes Beus ajoute dans la préface de l’étude : « Il s’agit d’un état des lieux honnête de ce que l’intelligence artificielle est réellement capable de faire aujourd’hui et des domaines dans lesquels l’être humain reste indispensable. »
Plus d'informations : https://wortliga.de/